Prompt Caching 实战全解:Anthropic vs OpenAI vs Gemini 缓存机制深度对比(2026)
分析日期:2026-08-14
涉及产品:Anthropic Claude、OpenAI GPT 系列、Google Gemini 2.5+
核心问题:如何让同样的 prompt 重复调用时少付 90% 的输入 token 费?
一、为什么要认真看待 Prompt Caching?
LLM API 计费的核心公式很简单:输入 token 价格 × 输入 token 数 + 输出 token 价格 × 输出 token 数。当你的 system prompt 有 3000 token、RAG 上下文有 5 万 token、工具定义又占 2000 token,每次请求都在为这些”几乎不变的内容”重复付费。
Prompt Caching 的本质:把每次请求的”共享前缀”缓存起来,重复调用时只对新增部分做完整前向传播(prefill)。三家大厂 2026 年都已落地,但机制、计费、最低门槛差别很大。


AI 上下文窗口全指南——预算管理与 Prompt Caching 成本优化实战
2026 年主流模型的上下文窗口已达百万级,Prompt Caching 把重复前缀成本砍掉 90%。本文系统梳理窗口上限、长上下文惩罚、三家主流平台的缓存机制与成本优化实战。


AI 代码助手全面对比:2026 年该选哪一个?
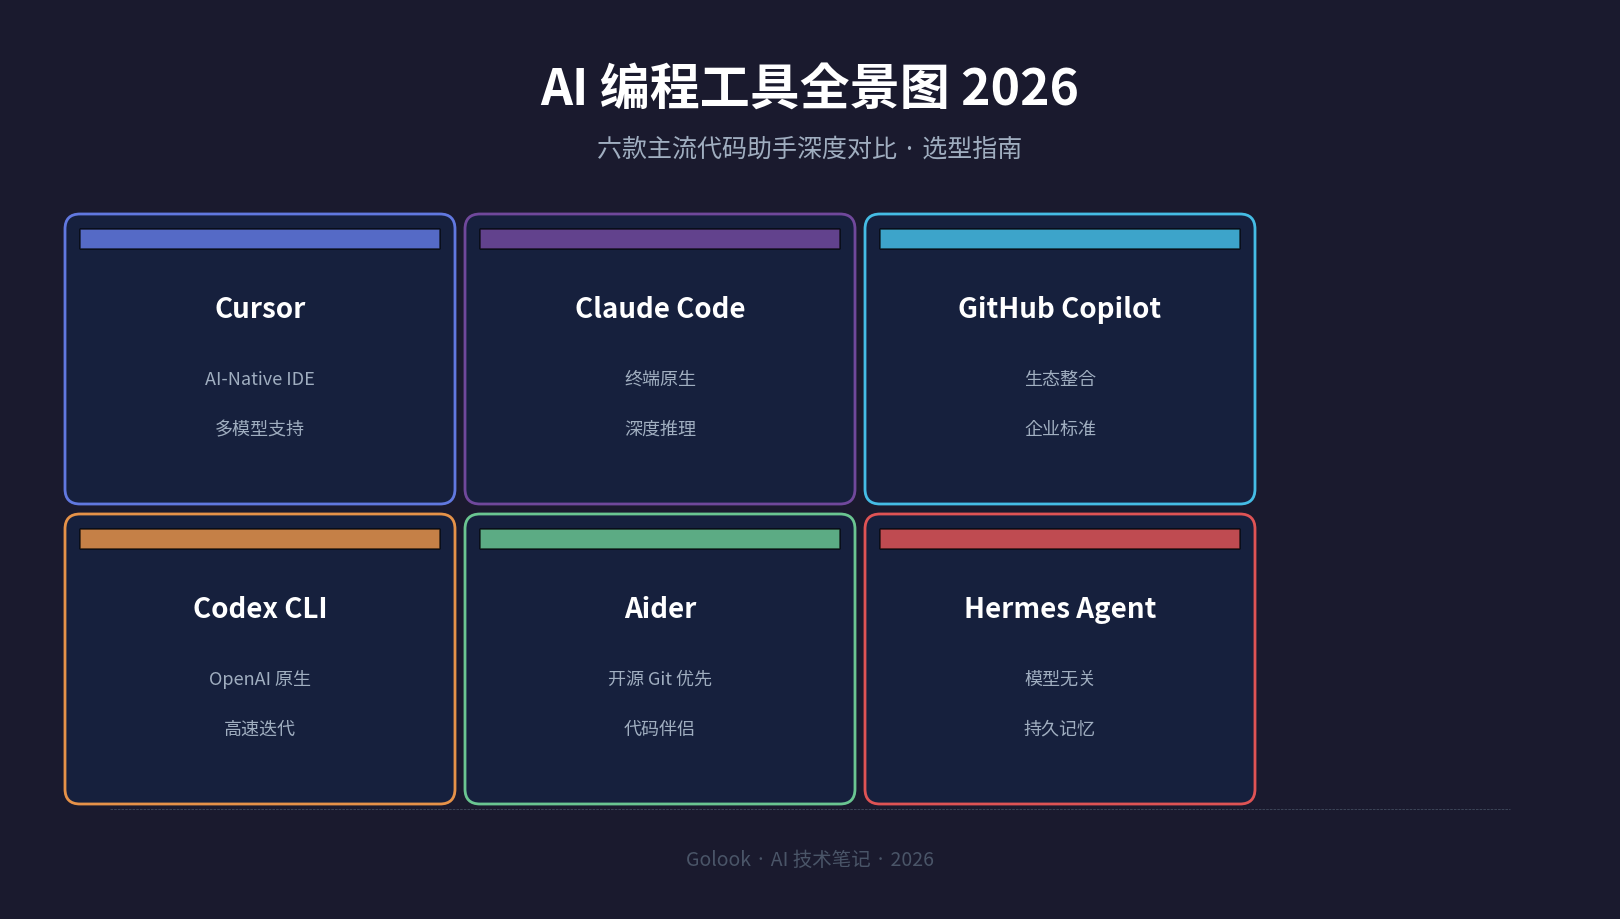
如果你每天写代码,大概率已经用过甚至同时订阅了多种 AI 代码助手。但 2026 年的格局变化太快——GitHub Copilot 在 6 月改成用量计费、OpenAI 推出 $100/月的 Codex Pro 5x 直接对标 Claude、Cursor 从免费 IDE 变成了积分制付费——旧的对比文章已经严重过时。
这篇文章基于 2026 年 4–7 月的真实数据(SWE-bench 基准测试、官方定价页、社区反馈),对 Cursor、Claude Code、GitHub Copilot 和 OpenAI Codex 四个主流工具做一次实战级对比,帮你判断该把预算押在哪一个上。
一、先看硬指标:SWE-bench 基准测试
SWE-bench 是目前最权威的 AI 代码能力评测,要求 Agent 在真实开源仓库中定位并修复 GitHub Issue。数据截至 2026 年 4 月:
Claude Computer Use 深度解析:AI 如何真正操控你的电脑
Computer Use 让 Claude 能看屏幕、动鼠标、敲键盘——这篇文章拆解它的技术架构、API 调用方式和 2026 年的最佳实践。
AI Agent 故障诊断实战:7 大故障模式与排查指南(2026)
传统软件 Crash 有错误码,AI Agent 却可能在输出格式完全正常的情况下彻底跑偏。本文系统梳理 AI Agent 七种常见故障模式(上下文退化、规格漂移、谄媚确认等),并给出可落地的四步诊断工作流。
2026 向量数据库全景对比:从 pgvector 到 Milvus,RAG 基础设施如何选型
2026 年主流向量数据库全面对比评测,覆盖性能基准、价格、部署方式与选型决策框架,帮你为 RAG 项目选对底层数据库。