2026 LLM 评估框架全景对比:LM-Eval-Harness · OpenCompass · DeepEval · RAGAS · Promptfoo · Phoenix
LLM 不会像传统软件那样”响亮地失败”。一个坏掉的 API 会抛异常;一个行为异常的 LLM 会生成一段语法完美、自信满满但完全错误的答案——而且如果你的栈里没有专门的 LLM 评估工具,没有任何东西会抓住它。
两年多前,大多数团队还在 Jupyter 笔记本里写临时 eval 脚本,然后自欺欺人地说”够用了”。今天,一个成熟的工具生态已经处理了从自动化幻觉检测、RAG 管道指标,到人工标注工作流和生产监控的全部环节。难点已经不是从零搭建评估基础设施了——而是搞清楚这几十个严肃工具里,哪一个真正值得你花时间。
本文基于 2026 年 10 月的最新社区数据(GitHub 星数、版本发布、收购动态),把整个 LLM 评估领域拆成三层,逐层对比工具的技术内核、适用场景、CLI 用法和 CI/CD 集成方式,最后给出可直接执行的选型逻辑。内容全部来自官方仓库、官方文档和一手社区数据。
TL;DR
- What this is: A three-layer map of the 2026 LLM evaluation ecosystem — capability harnesses, application metric frameworks, and hosted observability-plus-eval platforms — with verified star counts, CLI examples, and selection logic.
- This is for: Teams building AI agents, RAG pipelines, or chatbots who need to pick an eval framework, or teams shipping model/prompt changes without any quality gate.
- We chose: Layer 1 for model selection, Layer 2 for CI/CD quality gates, Layer 3 for human annotation and production visibility. Most teams need two tools — one open-source CI gate + one platform for collaboration.
一、为什么 2026 年评估框架成了必选项
先厘清几个容易混淆的概念。LLM 评估框架(evaluation framework)是”用可复现的数据集和定义好的指标,测试 LLM 应用质量的基础设施”。它不是:
- 学术基准(academic benchmark)—— 在 MMLU 等标准化任务上比较基础模型能力
- 评估平台(evaluation platform)—— 把同样流程包进托管层,供整个团队使用
- 可观测平台(observability platform)—— 捕获生产 trace、延迟、token 用量、错误
- 护栏(guardrail)—— 拦截实时请求并阻断、重试或改写响应
它们有重叠,但评估框架的核心工作是:在发布前,告诉你某个版本的 LLM 应用是否比另一个版本更好。因为它直接嵌在开发工作流里,一个好的评估框架甚至比一个只在上线后暴露问题的平台更有价值——它缩短了反馈循环,让你更快、更自信地开发。
2026 年的关键转折:评估领域已经分化为两个宽泛层级。开源框架住在你的 CI/CD 管道里(DeepEval、RAGAS、Promptfoo、LM-Eval-Harness、Phoenix、TruLens),商业平台服务于需要协作、标注和生产规模可观测的团队(LangSmith、Braintrust、W&B Weave、Arize AX)。两者在一个成熟的评估体系里都有位置——我们会告诉你分别何时用哪个。
一个资深团队反复收敛到的洞察是:你几乎肯定需要两个工具——一个轻量框架做 CI/CD 质量闸门,配一个平台做人工标注、回归追踪和利益相关者看板。这不是过度工程,而是让评估在你的应用和团队成长时保持可持续的分工。
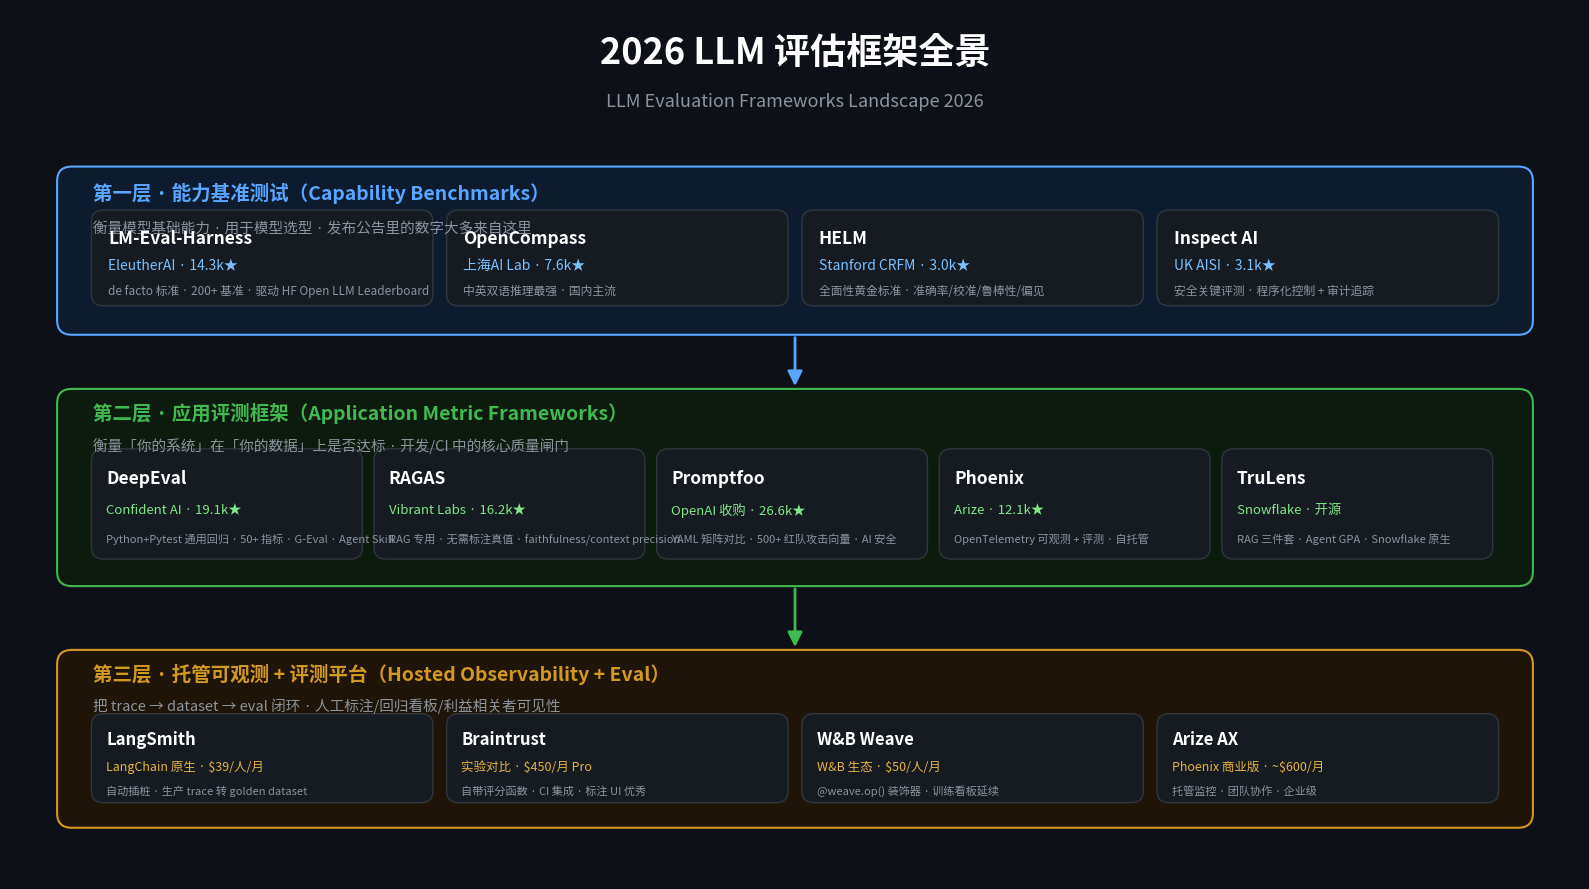
二、三层全景
| 层 | 干什么 | 典型工具 | 回答的问题 |
|---|---|---|---|
| 第一层:能力基准 | 在标准化任务上测模型基础能力 | LM-Eval-Harness、OpenCompass、HELM、Inspect AI | “这个模型一般有多强?” |
| 第二层:应用评测 | 测你的系统在你的数据上是否达标 | DeepEval、RAGAS、Promptfoo、Phoenix、TruLens | “我的聊天机器人回答得好吗?” |
| 第三层:托管平台 | 把 trace→dataset→eval 闭环 + 人工标注 | LangSmith、Braintrust、W&B Weave、Arize AX | “质量趋势如何?谁来审?” |
最容易犯的错误是混淆它们。 一个 MMLU 88 分的模型,不一定在你的客服任务上表现出色;一个通过你应用评测的系统,仍可能有只有基准才能暴露的能力缺口。生产团队两者都需要——模型选型时用基准,此后持续用应用评测。
三、第一层:能力基准测试(Capability Benchmarks)
3.1 LM-Eval-Harness(EleutherAI)—— de facto 标准
LM-Eval-Harness 是 LLM 评测的黄金标准基础设施,也是 HuggingFace Open LLM Leaderboard 背后的引擎。你在 Llama、Mistral、Gemma 之间看到的每一个 MMLU 分数、HellaSwag 结果、GSM8K 对比,都是用这个工具产出的。它是测量基础模型能力、对照标准化任务的学术标准。
- 仓库:
EleutherAI/lm-evaluation-harness· GitHub 14.3k ⭐(2026-09 仍在积极维护) - 许可证:MIT · 基准覆盖:200+ 任务,含 MMLU(多领域知识)、HellaSwag(常识推理)、TruthfulQA(事实性)、GSM8K(数学推理)、HumanEval(代码生成)
- 2025/12 起 CLI 重构:拆成子命令(
run、ls、validate),支持 YAML 配置文件(--config) - 2026/09 插件化:model backends、filters、metrics、aggregations 都可以从你自己的包注册(声明
lm_eval.entry point 零配置发现,或--plugins指向本地模块)
CLI 用法(2026 版):
1 | # 安装 |
关键参数:
--model hf:选择 HuggingFacetransformers后端;--model vllm用 vLLM(更快)--model_args:逗号分隔的关键字参数。pretrained=是模型 ID 或本地路径--tasks:逗号分隔的任务/组名--batch_size auto:让 harness 挑内存里能放下的最大 batch--device:计算设备(cuda:0、cpu、Apple Silicon 用mps)
它不做什么:评估应用。harness 在受控隔离下测模型对标准化任务——它对你的 system prompt、RAG 管道、检索质量、真实用户分布毫无概念。如果你的问题是”我更新了 prompt 模板后,聊天机器人回答变好了吗?”,LM-Eval-Harness 完全是错的工具。
适合:模型研究员、ML 团队选型/对比基础模型。学习曲线较陡——第一次用计划一天时间。大而全的基准套件即使在高性能硬件上也要跑数小时。
3.2 OpenCompass(上海 AI Lab)—— 中英双语推理最强
OpenCompass 是上海人工智能实验室开源的评测框架,在中文 + 英文推理上是最强的开源选择,也是国内主流模型(Qwen、DeepSeek、GLM 等)发布数字的主要来源之一。
- 仓库:
open-compass/opencompass· GitHub 7.6k ⭐(2026-10 积极维护) - 许可证:Apache 2.0
优势:中文基准覆盖远超西方工具——C-Eval(中文综合能力)、CMMLU(中文多任务)、CMath(中文数学)等,同时覆盖英文主流基准。支持分布式评测、多后端(HF/vLLM/API)、自定义任务。
1 | # 安装 |
3.3 HELM(Stanford CRFM)—— 全面性黄金标准
HELM(Holistic Evaluation of Language Models)是斯坦福 CRFM 的全面评测框架,在准确率之外同时衡量校准(calibration)、鲁棒性(robustness)、公平性(fairness)、偏见(bias)。
- 仓库:
stanford-crfm/helm· GitHub 3.0k ⭐ - 许可证:Apache 2.0
适合需要”整体画像”而非单点准确率的场景——尤其是模型上线前要评估系统性风险(偏见、公平性、鲁棒性)的团队。
3.4 Inspect AI(UK AISI)—— 安全关键评测首选
Inspect AI 是英国 AI 安全研究所(UK AI Safety Institute)维护的评测框架,为程序化控制和审计追踪而设计,被 UK AISI 用于前沿模型安全测试。
- 仓库:
UKGovernmentBEIS/inspect_ai· GitHub 3.1k ⭐ - 许可证:MIT
适合:安全关键型评估(安全测试、合规审计),需要明确的审计记录和可复现程序化控制。
1 | pip install inspect-ai |
四、第二层:应用评测框架(Application Metric Frameworks)
这一层操作在上一层的上一层:不是问”这个模型一般有多强”,而是问”这个具体管道,在这个具体数据集上,做这个具体任务做得怎么样”。
4.1 DeepEval —— 最接近 LLM 世界的 Pytest
DeepEval 是开源、Python 原生的 LLM 评估框架,工作起来像”针对 LLM 应用的 pytest”——测试用例、可复用指标、断言、阈值、以及为本地开发和 CI/CD 设计的 runner。
- 仓库:
confident-ai/deepeval· GitHub 19.1k ⭐(2026-10-29 更新) - 许可证:Apache 2.0 · 月下载:800 万+(PyPI,2026-07)
- 核心优势是广度:一个框架里覆盖 AI Agent、RAG 管道、多轮聊天、安全、自定义标准、合成数据生成、对话模拟、原生 tracing
关键特性:
- 50+ 开箱即用指标:AI Agent、RAG、多轮对话、安全、多模态应用、自定义标准
- G-Eval 和 DAG:自然语言评估规则 + 受控的决策图指标
- 端到端和组件级 AI Agent 评估:用原生 traces
- Pytest 集成:通过
assert_test()和deepeval test run - 合成数据集生成:从文档、上下文、已有 golden、或从零
- 场景驱动的多轮对话模拟
- 本地 trace 检查:
deepeval inspect按 span 打分并给出原因 - Agent Skill:面向 vibe-coding 评估循环(Claude Code / Cursor / Codex)
- 30+ 集成:跨 AI agent 框架、模型提供商、向量数据库
- DeepEval 4.0:为 Claude Code / Codex 等 AI 编码 agent 提供本地评估 harness——编码 agent 可生成数据集、跑 eval 套件、检查失败 trace、改相关 prompt 或组件、重跑直到指标通过
入门(CLI 命令均已验证语法):
1 | pip install deepeval |
Python 测试用例:
1 | from deepeval import assert_test |
CI/CD 集成:
1 | - name: Run LLM Evals |
设置每指标阈值(minimum_score=0.7),管道在质量回退时自动失败。黄金数据集先小——20-50 个代表性示例足够抓最常见的回退,又不会让 CI 慢得没法用。大多数团队一小时内跑通初始套件。
局限:规模成本。LLM-as-judge 指标每次评估要一次 judge API 调用,大测试套件上会快速累积。CI 的冷启动延迟也是真实考量——200 个示例的套件对远程 judge 要几分钟。
适合:Python 团队想要 pytest 风格 eval + 宽指标覆盖。不适合:想要纯 YAML 工作流、唯一需求是对抗性安全扫描、只要生产 trace 查看器、不能用 Python。
4.2 RAGAS —— RAG 专用,无需标注真值
RAGAS(Retrieval-Augmented Generation Assessment)是专为 RAG 管道设计的开源 Python 框架,帮助普及了 faithfulness(忠实度)和 answer relevancy(答案相关性)这类无参考指标,以及 context precision / recall 这类检索指标。
- 仓库:
vibrantlabsai/ragas· GitHub 16.2k ⭐ - 许可证:Apache 2.0
- 概念映射清晰:直接对应 RAG 系统的两大失败点——检索器是否找到对的信息、生成器是否忠实使用了那个信息
核心指标:
- Faithfulness、answer relevancy、context precision、context recall、answer correctness
- 无参考和有参考两种评估选项
- 合成 RAG 测试集生成
- AI Agent 指标:tool-call accuracy、tool-call F1、topic adherence、agent goal accuracy
入门:
1 | pip install ragas langchain-openai datasets |
1 | from datasets import Dataset |
核心卖点:所有核心指标设计为不需要参考答案——RAGAS 用 LLM 评估,意味着你可以直接跑生产流量,无需先整理标注数据集。这是快速推进团队的重大时间节省。
局限:范围刻意狭窄。RAG 失败模式覆盖得极好,但如果你要评估没有检索的通用聊天机器人、或测代码生成质量,RAGAS 会留下明显缺口。混合负载建议 RAGAS 做检索层 + DeepEval 做应用层。
适合:RAG 是主要或唯一要评估的 LLM 应用。不适合:需要一个框架覆盖 AI Agent + RAG + 多轮聊天、需要原生 tracing 和组件级评估、需要 Pytest/CI 工作流。
4.3 Promptfoo —— 提示词对比与 AI 安全专家
Promptfoo 是开源的 CLI 和库,用于测试提示词、对比模型提供商、对 LLM 应用做红队测试。它是配置优先:prompts、providers、tests、assertions 通常定义在 YAML 里。
- 仓库:
promptfoo/promptfoo· GitHub 26.6k ⭐(2026-10 更新,本项目最多星) - 许可证:MIT
- 2026 关键动态:OpenAI 已同意收购 Promptfoo,计划把技术整合进 OpenAI Frontier。项目保持 MIT 开源,但路线图对评估多模型提供商的团队来说不再那么厂商中立
关键特性:
- YAML 驱动的 prompt、provider、test-case、assertion 配置
- 并排模型和 prompt 对比
- 字符串/JSON/延迟/成本/自定义逻辑的确定性断言
- LLM-as-judge 打分和自定义规则
- 自动化红队和漏洞扫描:500+ 对抗攻击向量(prompt injection、jailbreak、PII 泄漏、有害内容、过度代理、不安全工具使用)
- AI Agent 和 RAG 目标(通过自定义 provider 和集成)
- CI/CD 支持和可分享报告
入门(YAML 配置,promptfoo eval):
1 | # promptfooconfig.yaml |
1 | promptfoo eval && promptfoo view |
核心卖点:侧边对比。一次定义测试用例,跑 GPT-4o、Claude、Llama、Mistral 等 30+ 提供商,输出矩阵精确显示每个模型在每个测试用例上的表现。红队套件是开源分类里最全面的。
局限:应用层深度。Promptfoo 擅长 prompt 级和模型级对比,但提供不了 DeepEval 的应用指标深度——开箱即无 RAG 特定指标或自定义领域规则。Python 原生团队可能觉得 Node.js / YAML 工作流与现有工具摩擦。
适合:模型选择决策、prompt 加固、安全红队。不适合:想要 Python 原生 Pytest 深度集成、需要 AI Agent/RAG/多轮指标宽目录、需要合成数据集生成。
4.4 Arize Phoenix —— 开源可观测 + 评测
Phoenix 是围绕 OpenTelemetry 和 OpenInference 构建的 AI 可观测和评估平台。它捕获 LLM 应用的 traces,提供 UI 检查模型调用、检索步骤、工具调用、延迟、token 用量和评估结果。
- 仓库:
Arize-ai/phoenix· GitHub 12.1k ⭐ - 许可证:Elastic License 2.0
- 定位:可观测是起点。团队收集生产 traces、识别问题示例、转成数据集、通过实验对比应用版本
- OpenTelemetry 原生架构是差异化亮点:用 OTEL 标准做插桩,任何支持 OTel spans 的框架/提供商都能工作
1 | pip install "arize-phoenix>=5" |
局限:UI 打磨不如 Braintrust/LangSmith;跳商业 Arize tier 的悬崖陡(生产监控约 $600/月);双产品定位偶尔造成”哪个功能在开源 tier 哪个在商业云”的困惑。
适合:生产 tracing 和可观测是首要需求、栈已用 OTel/OpenInference、想本地免费起步且有清晰商业升级路径。
4.5 TruLens —— RAG 三件套 + Snowflake 原生
TruLens 是开源 Python 库,用于插桩、评估、对比 LLM 应用。Snowflake 收购 TruEra 后接管项目。
- 仓库:
truera/trulens· 开源(Snowflake 主导) - 核心抽象是 RAG 三件套:groundedness(答案是否忠于检索上下文)、context relevance(检索上下文是否相关)、answer relevance(答案是否回答了问题)
- AI Agent 焦点增强:logical consistency、execution efficiency、plan adherence、plan quality、tool selection、tool calling、tool quality
- Agent GPA:跨 goals、plans、actions 评估
适合:已在 Snowflake 生态、想要 OTel 插桩和 trace 评估、RAG groundedness 和 Agent GPA 优先。局限:路线图转向企业数据平台集成,非 Snowflake 团队从 DeepEval/RAGAS 获得更高开发速度。
五、第三层:托管可观测 + 评测平台
开源工具擅长自动化评估,但不擅长组织层:标注队列、人工反馈工作流、回归看板、非工程利益相关者能用的协作界面。过了原型阶段,商业平台成为工程评估和产品质量之间的”结缔组织”。
5.1 LangSmith —— LangChain 团队的最优选择
LangSmith 是 LangChain 的托管评估和可观测平台。如果你的栈基于 LangChain/LangGraph,它几乎不可避免——而且有充分理由。
- 自动插桩:改一个环境变量,每次 LangChain/LangGraph 运行都被自动 trace 和记录
- 数据集管理 UI:从生产 traces 整理 eval 集——标记触发坏响应的真实用户查询、加进 golden dataset、下个 CI 循环自动跑
- 标注队列:把模糊输出路由给人工审阅者,可配置规则 + 审批工作流
- 生产在线评估:自动化 evaluator(含 LLM-as-judge)对生产流量持续运行,在累积成可见用户影响前暴露质量退化
定价:免费 5,000 traces/月;Team $39/人/月;Enterprise 定制。
风险是比例耦合:LangSmith 的价值直接随你的 LangChain 占比缩放。迁移到裸 API 调用、换编排框架、或构建无 LangGraph 的 agentic 架构时,自动插桩消失,LangSmith 变成一个能力但通用的 eval 平台。
5.2 Braintrust —— 企业级实验追踪
Braintrust 为想按 ML 实验追踪的严谨性把 eval 集成进部署管道的团队而建。
- 核心抽象是实验:每次 eval 运行创建带时间戳的实验,含每测试用例分数、随时间趋势、对比前次实验的 diff 视图
- CI/CD 一等公民:Python 和 TypeScript SDK,从 GitHub Actions 推 eval 结果进 Braintrust,分数回退时失败构建
- 人工标注打磨好:可配置规则、多标注者支持 + 标注者间一致性追踪、非工程师无需教程即可用 UI
定价:免费(1 用户、有限实验);Pro $450/月;Enterprise 定制。
权衡:Braintrust 不捆绑 LLM 评估指标——你自带评分函数。前期工程投入更多,但评估完全按你的应用定制。已投资好自定义指标的团队会发现 Braintrust 的实验基础设施是最佳运行地。
5.3 W&B Weave —— W&B 团队的天然延伸
Weights & Biases 靠 ML 训练实验追踪立足。Weave 是把该平台延伸进 LLM 评估。
@weave.op()装饰器是招牌:应用到 LLM 管道的任意 Python 函数,W&B 自动 trace 输入、输出、延迟、元数据。无手动插桩样板- 可视化基础设施是平台最强套件:trace explorer、score dashboards、并排输出对比视图
定价:免费 100GB 存储;Teams $50/人/月;Enterprise 定制。
局限:非 W&B 生态的团队 LLM 特定指标覆盖落后 DeepEval;RAG 评估支持弱于 RAGAS/DeepEval;全平台成本和工具开销难以为非训练团队证明。
5.4 Arize AX —— Phoenix 商业版
Arize AX 是 Phoenix 的托管商业层:托管监控、团队协作、企业级控制。
定价:生产监控约 $600/月起。升级路径清晰:本地免费起步,监控需求增长时扩展,无需迁移工具或重写插桩。
六、如何选:决策逻辑
6.1 按使用场景
| 场景 | 首选工具 | 次级工具 | 预算 |
|---|---|---|---|
| RAG 应用 | RAGAS | DeepEval(更宽应用指标) | $0 |
| 聊天机器人 / 对话 AI | DeepEval | LangSmith 或 Braintrust | $0–$450/月 |
| 代码生成 | DeepEval + 自定义指标 | Braintrust(实验追踪) | $0–$450/月 |
| 多 Agent 工作流 | Arize Phoenix | Braintrust | $0–$600/月 |
| 基础模型选型 | LM-Eval-Harness | Promptfoo(prompt 级对比) | $0 |
| 红队 / 对抗测试 | Promptfoo | DeepEval(附加指标) | $0 |
| 生产监控 | Arize Phoenix | LangSmith(若 LangChain 栈) | $0–$600/月 |
6.2 按团队画像
- 独立 ML 工程师 / 早期创业 → DeepEval(MIT,本地运行,无基础设施)或 Promptfoo(模型对比优先)。两者完全无需账号或云
- Python 原生工程团队 → DeepEval 做 CI eval + Braintrust 做生产可追溯性。这是 2026 年工程主导 AI 产品团队的事实标准组合
- LangChain / LangGraph 团队 → LangSmith 是明显选择。自动插桩和数据集整理节省大量时间
- 已跑 W&B 的 MLOps 团队 → W&B Weave 自然延伸
- Snowflake 数据栈企业 → TruLens(若原生集成重要),否则更广泛的社区工具提供更强指标覆盖
6.3 按预算
- $0 → DeepEval、RAGAS、Promptfoo、LM-Eval-Harness、TruLens、Arize Phoenix(自托管)全功能可用。六个严肃工具零许可成本
- $500/月以下 → LangSmith Team($39/人/月)或 W&B Teams($50/人/月)叠加在开源框架上覆盖全生命周期
- $500–$2,000/月 → Braintrust Pro($450/月)或 Arize AX 云——适合每天跑自动 eval + 活跃人工标注工作流
- 企业 → Braintrust Enterprise 或 Arize AX 企业 tier 定制合同(需要 SOC 2、SSO、审计日志、SLA)
6.4 两工具策略(生产团队收敛的模式)
一个开源框架做 CI/CD 自动化评估 + 一个平台做人工标注、回归追踪、利益相关者可见性。分工清晰:CI/CD 框架每次部署自动运行,在指标回退到达生产用户前抓住它——这是质量闸门。平台给 PM 和非工程利益相关者可见性,支持边缘案例的结构化人工审阅。
经过验证的组合:
- DeepEval + Braintrust —— Python 团队最佳全能,无 LangChain 依赖;CI 自动化和实验可追溯性都强
- RAGAS + LangSmith —— LangChain/LlamaIndex 上的 RAG 自然;原生集成最小化胶水代码
- DeepEval + Arize Phoenix —— 两侧都开源 + 生产监控可选云升级路径
七、LLM-as-Judge 的坑(重要)
现代应用评估高度依赖 LLM-as-judge 对开放式输出打分。校准 judge 是最大的误差来源,也是最常被团队忽视的实践。
三个已知偏差(Zheng et al. 2023, arXiv:2306.05685):
- 冗长偏差(verbosity bias):judge 倾向给更长的回答更高分
- 位置偏差(position bias):judge 倾向给特定位置的选项更高分
实践建议:
- 用与系统不同的模型族做 judge。LLM-as-judge 偏向自己族的输出(自增强偏差)。对 Llama-70B 服务的系统,用 Claude 或 GPT-4 类做 judge
- 校准:把 judge 对一小份人工打分集合校准——这是最大误差来源
- 成本控制:LLM-as-judge 每次评估要 judge API 调用。规模时用便宜 tier judge(季度校准),前端模型留给 nightly
G-Eval 规则要具体:规则太模糊(”它好吗?”)会被忽略。改写为带通过/失败示例的编号标准,并对照人工分数再校准。
八、10 分钟跑通第一个评估(DeepEval 实操)
1 | # 1. 安装 |
输出镜像 pytest:每个测试用例按指标通过/失败,带数字分数和 judge 的原因。失败的 HallucinationMetric 读起来像:Score: 0.35 (threshold: 0.7) — The response states X, which is not supported by the provided context and contradicts source Y. 这是可行动的——你确切知道哪个用例、哪个指标、为什么失败。
下一步(ROI 最高):
- 加自定义指标——G-Eval 用自然语言定义领域标准(合规语言、引用格式、语气要求)
- 建回归数据集——每次在生产抓到真实失败,把示例加进 eval 集。几周内得到反映实际失败模式的数据集
- 接平台——把 DeepEval 结果 pipe 进 Braintrust/LangSmith 做趋势追踪、人工标注、利益相关者看板
规模建议:黄金数据集 20-50 个示例起步,保持 CI 运行 5 分钟内。一致性胜过完美——一个每 PR 跑的简单 eval(3 个指标、30 个用例、CI 5 分钟)抓的回退比一个你设置一次就忘掉的全面框架多得多。
九、常见坑速查表
| 症状 | 根因 | 修复 |
|---|---|---|
| CI judge 成本爆炸 | 每次 PR 用前端 judge + 大数据集 | CI 换便宜 tier judge(季度校准),前端 judge 留给 nightly |
| MMLU 分数差 2-3 分 | harness 版本漂移 / prompt 模板不同 | 锁 LM-Eval-Harness 版本;用模型卡的规范 prompt 模板 |
| Phoenix UI 空但应用已插桩 | OpenInference handler 未注册 / 项目错误 | 验证 LlamaIndexInstrumentor().instrument() 在首次 trace 前运行 |
| eval 分数 dev 好 prod 差 | 数据集不具代表性;prod 有长尾内容 | 加生产流量采样示例进数据集;按失败模式打 tag |
| G-Eval 规则被忽略 | 规则太模糊(”它好吗?”) | 改写为带通过/失败示例的编号标准;对照人工分数再校准 |
| CI eval 分数骤降 | 数据集/judge/框架版本漂移 | 按序检查:①数据集版本锁定?②judge 模型版本锁定?③框架版本锁定?十有八九是其中之一静默漂移 |
十、结论
一致性胜过完美。 一个每 PR 运行的简单 eval——三个指标、30 个测试用例、CI 五分钟——比一个你的团队设置一次就忘掉的全面评估框架抓到的回退更多。从小做起,让它自动化,随应用和数据集成熟再扩大覆盖。
对 2026 年大多数团队,务实路径清晰:用 DeepEval 做自动 CI eval 和宽 Python 原生指标覆盖;建 RAG 应用就加 RAGAS;需要人工标注工作流和回归看板(非工程师无需教程就能导航)时,升级到商业平台(Braintrust、LangSmith 或 Arize)。
你花在接第一个 eval 循环上的 20-30 分钟,会在每次发布模型更新、prompt 变更或检索配置调整时得到回报。没有评估,那些变更静默落地——毫无预警地破坏用户依赖的东西。评估不是合规复选框——它是让发布 LLM 驱动产品感觉像工程而不是猜测的反馈循环。
❓ 常见问题(FAQ)
Q: LLM 评估和 LLM 基准测试有什么区别?
基准测试在标准化任务(MMLU 测多领域知识、HumanEval 测代码生成、TruthfulQA 测抗虚假)上测模型一般能力,告诉你模型在受控条件下能做什么,独立于任何具体应用。应用评估测你的 LLM 应用在你的数据上、用你的 system prompt、对你的用户和真实查询表现如何。大多数生产团队需要应用评估;模型基准用于基础模型选型,但不告诉你聊天机器人的输出对你的用例好不好。
Q: 哪些 LLM 评估工具免费且开源?
六个完全免费开源:DeepEval(Apache 2.0)、RAGAS(Apache 2.0)、Promptfoo(MIT)、LM-Eval-Harness(MIT)、TruLens(MIT)、Arize Phoenix(Elastic 2.0,自托管;商业 Arize 云是付费产品)。
Q: 我可以在 CI/CD 里用 LLM 评估工具吗?
可以——而且对任何生产 LLM 应用,你都应该。DeepEval、Promptfoo、Braintrust 是生态里最 CI-ready 的。标准模式:定义黄金数据集测试用例 + 期望质量阈值,每次 PR 或部署事件跑 eval,关键指标(幻觉率、忠实度分数)低于配置阈值时失败构建。20-50 个示例起步保持 CI 运行 5 分钟内。发布模型或 prompt 更新没有 CI eval 循环 = 盲目飞行:LLM 版本间静默回退是到达用户的常见生产质量问题来源。
Q: 如何评估 RAG 管道?
稳健的 RAG 评估回答三个问题:检索到对的上下文了吗?模型对检索到的内容保持忠实了吗?答案实际回答用户问题了吗?①Context precision——检索到的 chunk 里多少实际相关?②Faithfulness——生成答案的每个声明是否忠于检索上下文?③Answer relevancy——答案是否回答了实际被问的问题?RAGAS 用最小配置和无标注数据集要求覆盖三者,是获得有意义 RAG 结果的最快路径。在 50-200 个 query-context-answer 三元组的代表性数据集上运行以获统计显著结果。
Q: 如何为开放式输出评估准确性?
对已知正确答案的任务(事实 Q&A、数学推理、结构化抽取),基于参考的评估(exact match、ROUGE-L、BERTScore)快且便宜。对正确答案可多样的开放式生成,LLM-as-judge 是可扩展路径:用更强模型(GPT-4o、Claude 3.5 Sonnet)对照定义规则打分。RAG 应用特定地,对检索上下文的忠实度往往比孤立的事实准确性更有意义的代理——RAGAS 和 DeepEval 都提供专用忠实度指标,对检索增强系统比通用准确率分数更可靠。
Q: DeepEval 必须配合 Confident AI 用吗?
不需要。DeepEval 是独立 Apache 2.0 开源框架,本地运行。Confident AI 可选,添加共享报告、实验、数据集、可观测、监控、企业协作。
Q: 需要多个 LLM 评估工具吗?
可以。例如团队可能用 DeepEval 做主回归套件、Promptfoo 做专门红队。权衡是跨数据集、指标 API、traces、报告的碎片化——保持一个框架作为发布质量的事实来源。